教程
汇集 DigitalOcean 购买与使用教程、Droplet 云服务器部署、海外云服务器选型、GPU 与 AI 推理、Kubernetes、数据库、存储和 App Platform 实战,覆盖账号注册、模型部署、性能优化、安全配置与成本比较,帮助开发者按业务场景选择合适的云产品并完成稳定上线与持续优化。
精选文章
Kimi K3 + Claude:AI Agent 多模型路由实战
AI Agent 不同任务对模型能力的需求并不相同。本文以 Kimi K3 和 Claude 为例,介绍如何通过模型路由动态选择合适的模型,在兼顾任务质量和性能的同时,减少不必要的推理成本。
全部文章
Kimi K3 + Claude:AI Agent 多模型路由实战
AI Agent 不同任务对模型能力的需求并不相同。本文以 Kimi K3 和 Claude 为例,介绍如何通过模型路由动态选择合适的模型,在兼顾任务质量和性能的同时,减少不必要的推理成本。

RAG 的 Embedding 模型需要微调吗?什么时候值得自己训练?
什么时候该继续用现成 Embedding API,什么时候值得自己微调?本文从 Recall@10、训练数据、向量维度和长期成本出发,给出判断方法,并介绍如何用 DigitalOcean GPU 与 PostgreSQL托管数据库搭建一套更可控的 RAG 检索架构。

从API到专用GPU:2026年5大适合创业团队的AI推理平台深度对比
2026 年面向初创公司的 AI 推理服务商选型指南,深度对比 DigitalOcean、Groq、Replicate、Fireworks AI、Together AI 五家平台。从冷启动、缩容至零、扩展路径等维度评估,帮你找到从原型到生产的最优解,避免增长期的昂贵迁移。
加了 1 个参数,GLM-5.3-Flash 便宜了 6.3 倍
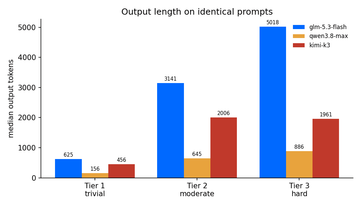
GLM-5.3-Flash API 到底要花多少钱?本文通过 2700 次真实调用,对比 GLM-5.3-Flash、Qwen3.8-Max 与 Kimi K3 的 Token 消耗和实际成本,并实测 reasoning_effort 如何将推理费用降低 6.3 倍。

Baseten vs DigitalOcean、RunPod:7 个 AI 模型部署平台横向对比
Baseten 替代方案对比:DigitalOcean 按 Token 计费、免冗余实例常驻,一个 Key 同时访问 70+ 开放模型与 OpenAI/Anthropic 前沿模型,推理与数据库、存储同账单;另有 Fireworks AI、Together AI、RunPod 可选。
DigitalOcean批量推理实战:25万条记录零失败,成本仅7.04美元,完整实测与竞品对比
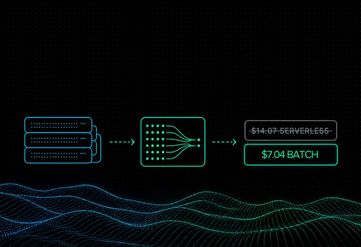
DigitalOcean批量推理实战:25万条记录处理成本仅7.04美元,较无服务器推理节省50%,零失败完成。对比OpenAI、Anthropic、AWS Bedrock四家方案,含完整实测数据与8条避坑经验,附开源代码,帮你选对大规模LLM推理平台。
2026 LLM 成本计算指南:Token 价格、推理费用与降本方法
详解 LLM Token 计费、缓存、Batch、RAG、Agent 与模型路由成本,并给出企业 AI 推理费用计算和实际降本方法。
Qwen3.8-2.4T-A95B 部署与性能解析:DigitalOcean 无服务器推理实测
Qwen3.8-2.4T-A95B 已上线 DigitalOcean 推理引擎。本文从模型架构、性能实测、上下文窗口、工具调用、批量推理到价格进行解析,并介绍其在无服务器推理与多模型路由中的使用方式。
AI Agent 性能优化:如何用无服务器推理降低延迟、提升响应速度?
本文通过一个真实 AI Agent 案例,拆解 TTFT、上下文、并行工具调用等关键优化方法,并分析无服务器推理何时该转向专属或自托管。

AI 应用成本怎么算?从推理费用到完整 TCO 拆解
生产级 AI 应用的成本远不止 Token 费用。本文从推理、计算、向量数据库、存储、网络和运维等环节拆解完整 TCO,并对比单一平台与多平台架构下的实际成本差异。

DigitalOcean 无服务器推理支持提示词缓存:降低 AI 推理成本与延迟
DigitalOcean 无服务器推理已经支持提示词缓存。对于 AI Agent、RAG、智能客服和代码生成等需要反复提交长上下文的应用,合理使用提示词缓存,可以减少重复计算,降低输入 Token 成本,并缩短首 Token 响应时间。

LLM 多模型路由终极指南:架构设计、成本优化与平台选型
真正在跑生产环境的团队,默认都会走多模型厂商路由。本文会讲清楚这套架构为什么成立,以及 DigitalOcean 的一级推理路由器在其中扮演什么角色——所有成本数据都来自 inference.do-ai.run 上可复现的实测,不是市场宣传材料。路由策略本身是平台无关的,你可以在任何一家厂商上用同样的思路去落地。

部署 Kimi K3 需要多少 GPU?自托管与 API 成本对比
Kimi K3 拥有2.8万亿参数,部署约需1.5TB显存及8张高端GPU。本文对比自托管、专用推理与无服务器API的成本、硬件和适用场景,帮助团队根据Token用量、并发、数据隐私及运维能力选择部署方式。
OpenAI API如何迁移到兼容平台?代码修改与功能差异详解
介绍如何将 OpenAI API 迁移至 DigitalOcean 无服务器推理,并说明兼容端点、代码修改与功能限制。
AI 推理服务迁移指南:从 OpenAI、Anthropic 切换到多模型推理云
介绍如何将 AI 推理从 OpenAI、Anthropic 迁移至多模型云,涵盖接口修改、兼容性测试与上线流程。
DeepSeek v4 Pro / GLM 5.2 / Kimi K2.6 / GPT 5.6 Sol:4 款大模型在 DigitalOcean 无服务器推理上的成本与能力对比
Kimi K2.6、DeepSeek v4 Pro、GLM 5.2、GPT 5.6 Sol——四款模型在 DigitalOcean 无服务器推理上的定价分别为 $0.76/$1.39/$1.05/$5.00(输入,/M tokens)和 $3.20/$2.78/$4.40/$30.00(输出)。本文通过定价对比、TTFB 一致性和场景化成本测算,拆解哪个模型在什么场景下最划算,以及如何用 Inference Router 实现跨模型自动路由将总成本降低 70% 以上。
大模型推理选型:无服务器 API、专用推理与 GPU 实例自建成本实测与盈亏平衡点指南
实测对比无服务器推理、专用推理与租 GPU 实例自建推理服务,三种 LLM 部署方案的真实成本与性能,找到盈亏平衡点,帮助创业公司做出更合理的推理架构决策。
如何为你的 AI 推理业务场景选择合适的大语言模型
本文详细讲述一种可复用的模型选择方法:通过在自有数据上进行评估来挑选推理模型,并结合来自 DigitalOcean 无服务器推理(Serverless Inference)的第一手成本数据。