#AI
汇总 AI 推理、大模型 API、RAG、模型部署和生成式 AI 应用文章,覆盖云端开发、性能优化与基础设施选型。
全部文章

DigitalOcean vs OpenRouter:2026 年 AI 模型路由对比
DigitalOcean 与 OpenRouter 都能通过统一 API 接入多个模型,但在模型托管、路由策略、成本、可靠性和基础设施整合上存在明显差异。本文从实际应用场景出发,对比两种方案各自适合的 AI 工作负载。
Kimi K3 + Claude:AI Agent 多模型路由实战
AI Agent 不同任务对模型能力的需求并不相同。本文以 Kimi K3 和 Claude 为例,介绍如何通过模型路由动态选择合适的模型,在兼顾任务质量和性能的同时,减少不必要的推理成本。

RAG 的 Embedding 模型需要微调吗?什么时候值得自己训练?
什么时候该继续用现成 Embedding API,什么时候值得自己微调?本文从 Recall@10、训练数据、向量维度和长期成本出发,给出判断方法,并介绍如何用 DigitalOcean GPU 与 PostgreSQL托管数据库搭建一套更可控的 RAG 检索架构。
从API到专用GPU:2026年5大适合创业团队的AI推理平台深度对比
2026 年面向初创公司的 AI 推理服务商选型指南,深度对比 DigitalOcean、Groq、Replicate、Fireworks AI、Together AI 五家平台。从冷启动、缩容至零、扩展路径等维度评估,帮你找到从原型到生产的最优解,避免增长期的昂贵迁移。
GPT 6 Astra 已上线 DigitalOcean AI 推理云:AGI 时代的计算机操作模型来了
GPT-6 Astra 登陆 DigitalOcean 无服务器推理,1.05M 上下文、五档推理强度,能自主操作电脑完成复杂任务。价格分长短两档(最低输入 $10/1M tokens),支持与 70+ 模型集成,为 AI Agent 提供旗舰级能力。
AMD旗舰GPU仅需4美元每小时,DigitalOcean上线Spot GPU实例
DigitalOcean AMD MI350X / MI355X Spot GPU 降至 $4/小时起。价格锁定、性价比极高,适合训练、批量推理等容错任务。
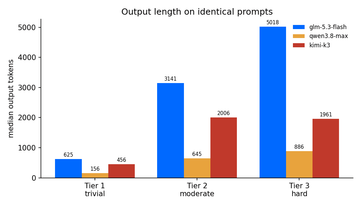
加了 1 个参数,GLM-5.3-Flash 便宜了 6.3 倍
GLM-5.3-Flash API 到底要花多少钱?本文通过 2700 次真实调用,对比 GLM-5.3-Flash、Qwen3.8-Max 与 Kimi K3 的 Token 消耗和实际成本,并实测 reasoning_effort 如何将推理费用降低 6.3 倍。

Baseten vs DigitalOcean、RunPod:7 个 AI 模型部署平台横向对比
Baseten 替代方案对比:DigitalOcean 按 Token 计费、免冗余实例常驻,一个 Key 同时访问 70+ 开放模型与 OpenAI/Anthropic 前沿模型,推理与数据库、存储同账单;另有 Fireworks AI、Together AI、RunPod 可选。
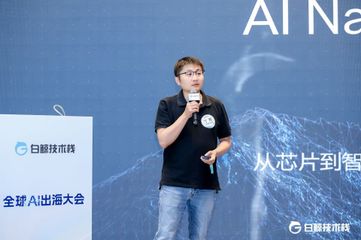
推理成本最高降40%+!卓普云科技丁可拆解Agent落地五层技术栈
卓普云科技丁可在全球AI出海大会上分享AI Agent五层技术栈及推理服务选型实践。他提出以推理路由、缓存感知路由和模型合成三管齐下,实现推理成本最高降低40%以上,并以GLM+Kimi组合以48%成本超越单模型质量,为AI出海企业提供从原型到规模化的清晰路径。
2026 LLM 成本计算指南:Token 价格、推理费用与降本方法
详解 LLM Token 计费、缓存、Batch、RAG、Agent 与模型路由成本,并给出企业 AI 推理费用计算和实际降本方法。
延迟降低 55%,9 台服务器撑起整套 AI 业务:这家公司怎么做到的?
AI-nhancement用DigitalOcean构建可治理AI架构,通过推理路由器统一调度Anthropic、OpenAI等模型,将延迟降低2.2倍。创始人仅凭自学,在Droplet上快速部署Mia个人AI伴侣与Anvil编程Agent,实现低成本、高可靠的多模型路由与混合云部署。
AI Agent 性能优化:如何用无服务器推理降低延迟、提升响应速度?
本文通过一个真实 AI Agent 案例,拆解 TTFT、上下文、并行工具调用等关键优化方法,并分析无服务器推理何时该转向专属或自托管。

AI 应用成本怎么算?从推理费用到完整 TCO 拆解
生产级 AI 应用的成本远不止 Token 费用。本文从推理、计算、向量数据库、存储、网络和运维等环节拆解完整 TCO,并对比单一平台与多平台架构下的实际成本差异。

DigitalOcean 无服务器推理支持提示词缓存:降低 AI 推理成本与延迟
DigitalOcean 无服务器推理已经支持提示词缓存。对于 AI Agent、RAG、智能客服和代码生成等需要反复提交长上下文的应用,合理使用提示词缓存,可以减少重复计算,降低输入 Token 成本,并缩短首 Token 响应时间。
多款模型最高直降 50%:DigitalOcean 无服务器推理大降价
DigitalOcean Serverless Inference 下调 7 款主流模型价格,覆盖 DeepSeek、Qwen、GLM、Llama、Nemotron 和 MiMo,最高降幅达到 50%。

LLM 多模型路由终极指南:架构设计、成本优化与平台选型
真正在跑生产环境的团队,默认都会走多模型厂商路由。本文会讲清楚这套架构为什么成立,以及 DigitalOcean 的一级推理路由器在其中扮演什么角色——所有成本数据都来自 inference.do-ai.run 上可复现的实测,不是市场宣传材料。路由策略本身是平台无关的,你可以在任何一家厂商上用同样的思路去落地。

部署 Kimi K3 需要多少 GPU?自托管与 API 成本对比
Kimi K3 拥有2.8万亿参数,部署约需1.5TB显存及8张高端GPU。本文对比自托管、专用推理与无服务器API的成本、硬件和适用场景,帮助团队根据Token用量、并发、数据隐私及运维能力选择部署方式。
OpenAI API如何迁移到兼容平台?代码修改与功能差异详解
介绍如何将 OpenAI API 迁移至 DigitalOcean 无服务器推理,并说明兼容端点、代码修改与功能限制。
AI 推理服务迁移指南:从 OpenAI、Anthropic 切换到多模型推理云
介绍如何将 AI 推理从 OpenAI、Anthropic 迁移至多模型云,涵盖接口修改、兼容性测试与上线流程。